Un LLM ne devient jamais vraiment capable d’agir. Il apprend à écrire un ordre structuré en JSON, et c’est votre code qui exécute l’action réelle. Le function calling, c’est ça : un protocole de délégation, pas de l’autonomie. Voici ce qui se passe vraiment sous le capot.
La plupart des démos d’agents IA que vous voyez en ligne montrent un chatbot qui «réserve un vol» ou «envoie un email». Ce qui n’est jamais montré, c’est la ligne de code derrière, celle qui exécute réellement l’action. Le function calling est le mécanisme qui relie ces deux mondes.
Comprendre ce mécanisme, c’est comprendre pourquoi un agent IA peut échouer une fois sur trois selon la qualité de sa configuration, et pourquoi la plupart des promesses marketing autour des agents autonomes sont fragiles.
En bref
- Ce que c’est : un protocole qui permet à un LLM de générer un JSON structuré décrivant une action à effectuer, plutôt que du texte libre.
- Ce que le LLM fait réellement : il écrit un ordre (nom de fonction + paramètres). Il n’exécute jamais rien lui-même.
- Ce qui exécute l’action : le code applicatif externe, toujours, sans exception.
- Le piège principal : la fiabilité dépend de la qualité de la description des outils fournis au modèle, pas du modèle lui-même.
- La confusion courante : function calling, tool calling et MCP sont trois choses différentes, souvent utilisées comme synonymes.
Au sommaire
- Function calling : la définition sans jargon
- Le mécanisme exact : de la question à l’action
- Ce que le LLM fait vraiment (et ce qu’il ne fait jamais)
- Pourquoi la fiabilité dépend de la rédaction des tool definitions
- Idée reçue vs réalité sur le function calling
- Ce que ça change pour vous
- Function calling : la nuance qu’on oublie souvent
Function calling LLM : la définition sans jargon
Le function calling est le mécanisme qui permet à un LLM de répondre par un ordre structuré au format JSON, plutôt que par du texte libre. Cet ordre indique à un programme externe quelle fonction exécuter et avec quels paramètres. Le LLM décide de l’action, mais ne l’exécute jamais.
Concrètement : vous posez une question à un assistant IA («Quelle est la météo à Lyon demain ?»). Au lieu de répondre «Je ne sais pas, mes données s’arrêtent à…», le modèle génère un objet JSON structuré.
Ce JSON ressemble à ça :
{"name": "get_weather", "parameters": {"city": "Lyon", "date": "demain"}}
Votre code lit ce JSON, appelle l’API météo réelle, récupère la réponse, et la renvoie au modèle. Qui formule alors la réponse finale à l’utilisateur. C’est tout.
Le mécanisme exact du function calling LLM : de la question à l’action
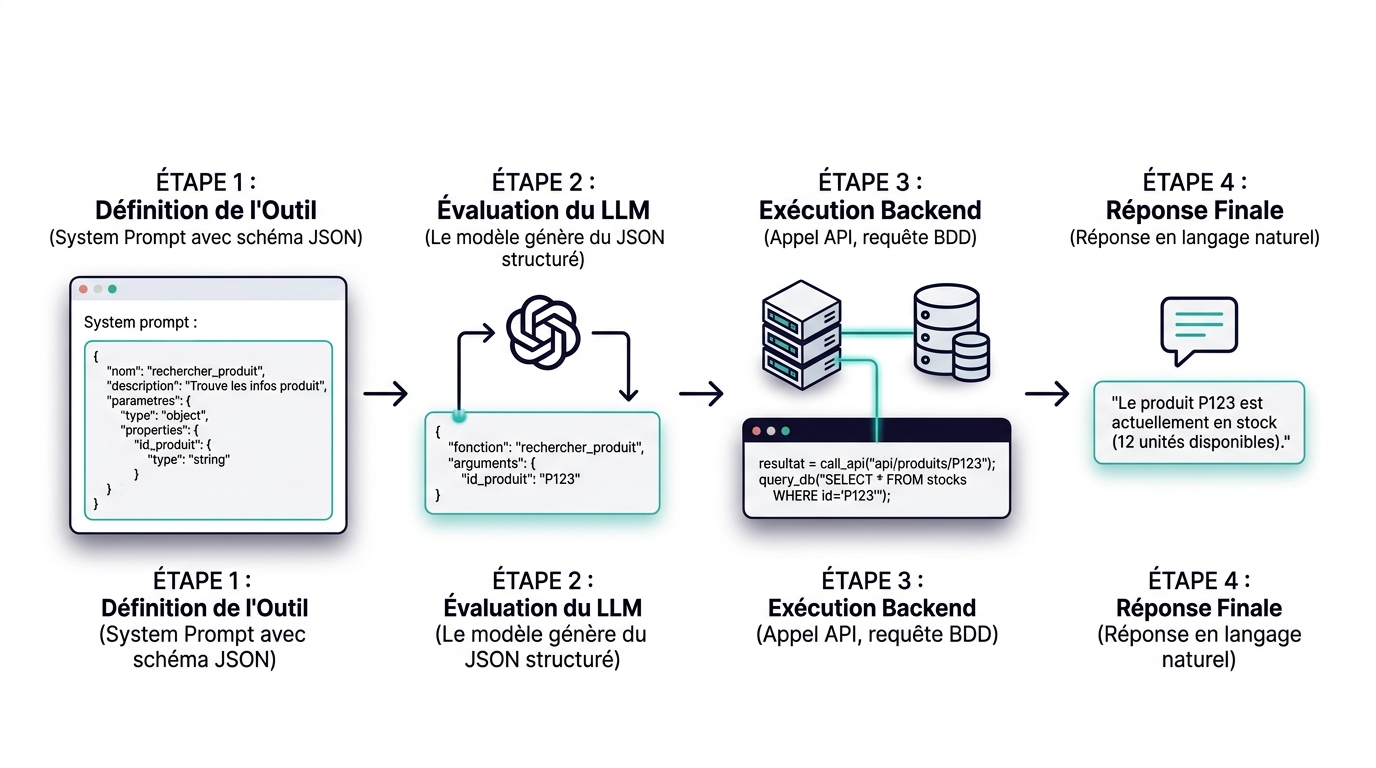
La boucle agentique suit toujours le même schéma en six temps. Pas une étape ne peut être sautée.
- Requête utilisateur : l’utilisateur envoie un message (texte libre).
- Décision du modèle : le LLM analyse la requête et les descriptions d’outils disponibles (les «tool definitions»). Il décide si une fonction doit être appelée et laquelle.
- Génération du JSON structuré : le modèle produit un objet JSON avec le nom de la fonction et les paramètres. Il s’arrête là.
- Exécution par le code : votre application lit le JSON, exécute la vraie fonction (appel API, requête base de données, envoi d’email). Le LLM n’est plus dans la boucle à ce stade.
- Observation : le résultat de l’exécution est renvoyé au modèle comme nouveau message dans le contexte.
- Réponse finale : le LLM lit l’observation et formule la réponse en langage naturel pour l’utilisateur.
Ce qui est important ici, c’est l’étape 4. Le LLM n’est plus actif pendant l’exécution. Il reprend la main uniquement à l’étape 5, quand le résultat lui est soumis.
Ce que le LLM fait vraiment dans le function calling (et ce qu’il ne fait jamais)
Le LLM est un générateur de texte. C’est tout. Il ne peut pas envoyer un email, interroger une base de données, ou créer un ticket Jira.
Ce qu’il fait avec le function calling, c’est générer un texte qui ressemble à un ordre de code, mais qui est toujours du texte. La magie, c’est que ce texte est assez structuré pour être interprété par un programme.
La frontière est nette :
- LLM : décide quelle fonction appeler, génère les paramètres au bon format, formule la réponse finale.
- Code applicatif : exécute la fonction réelle, gère les erreurs, renvoie le résultat.
Pourquoi cette distinction compte ? Parce qu’elle définit où se situe votre risque. Si le LLM génère un mauvais paramètre (un nom de ville mal orthographié, une date au mauvais format), l’appel API échoue. Ce n’est pas un bug du modèle au sens technique, c’est une erreur de génération textuelle.
Et c’est votre code qui doit gérer cette erreur, pas le modèle. Le LLM ne saura jamais que l’appel a échoué à moins que vous ne lui renvoyiez ce message d’erreur explicitement dans le contexte.
Pourquoi la fiabilité du function calling LLM dépend des tool definitions
C’est le point que personne ne montre dans les démos. La fiabilité du function calling ne dépend pas principalement du modèle choisi.
Elle dépend de la qualité des tool definitions, c’est-à-dire des descriptions que vous fournissez au modèle pour lui expliquer quelles fonctions existent et comment les utiliser.
Une tool definition bien rédigée ressemble à ça :
{"name": "create_crm_contact", "description": "Crée un nouveau contact dans le CRM. À utiliser uniquement quand l'utilisateur souhaite enregistrer une nouvelle personne. Ne pas utiliser pour mettre à jour un contact existant.", "parameters": {"email": {"type": "string", "description": "Adresse email valide du contact, format user@domain.com"}, "company": {"type": "string", "description": "Nom exact de l'entreprise, tel qu'il apparaît sur le site de l'entreprise"}}}
Ce niveau de précision dans la description change radicalement le taux de succès. Des benchmarks publiés sur des pipelines d’agents IA montrent des écarts de 30 à 40 points de pourcentage entre une tool definition vague et une tool definition précise, pour le même modèle sur la même tâche.
Les erreurs les plus fréquentes dans les tool definitions :
- Description trop vague : «Appelle l’API CRM» sans préciser dans quel cas utiliser cette fonction plutôt qu’une autre.
- Paramètres non documentés : un champ «date» sans préciser le format attendu (ISO 8601 ? DD/MM/YYYY ?) génère des erreurs systématiques.
- Trop de fonctions disponibles simultanément : au-delà d’une dizaine d’outils, les modèles actuels commencent à confondre les fonctions proches.
Pour approfondir les différences entre les approches techniques qui permettent à un LLM d’accéder à des données ou des outils externes, notre article sur RAG, fine-tuning et prompt engineering pose les bases de chaque méthode.
Vous déployez un agent IA et les résultats sont imprévisibles ?
On audite votre architecture de function calling et on identifie où ça casse.
Idée reçue vs réalité sur le function calling LLM
Idée reçue
- Le LLM «exécute» les actions lui-même : il envoie des emails, interroge des bases de données, crée des tickets en toute autonomie.
- Function calling, tool calling et MCP sont trois noms pour la même chose. On peut les utiliser indifféremment.
- Un agent qui utilise le function calling est fiable par défaut dès qu’il utilise un bon modèle comme GPT-4 ou Claude.
- Plus on donne d’outils au LLM, plus l’agent est puissant et capable.
Réalité
- Le LLM génère uniquement du JSON structuré décrivant une action. C’est toujours le code applicatif externe qui exécute réellement l’action.
- Function calling désigne la capacité native du LLM. Tool calling est un terme plus générique. MCP (Model Context Protocol) est un standard de communication entre modèles et serveurs d’outils, une couche au-dessus.
- La fiabilité dépend avant tout de la qualité des tool definitions rédigées par les développeurs. Une mauvaise description peut faire chuter le taux de succès de 40 points, quel que soit le modèle.
- Au-delà d’une dizaine d’outils exposés simultanément, les modèles actuels commencent à confondre les fonctions proches. Moins d’outils, mieux ciblés, donne de meilleurs résultats.
Ce que le function calling LLM change pour vous concrètement
Pour un CEO ou un directeur marketing, le function calling est la brique qui rend les agents IA utiles au-delà du chatbot. Sans lui, un LLM répond. Avec lui, un LLM peut déclencher une action dans votre CRM, votre outil de ticketing, ou votre système d’envoi d’emails.
Les cas d’usage qui fonctionnent en production aujourd’hui :
- Qualification de leads automatique : un agent reçoit un formulaire entrant, appelle une fonction d’enrichissement de données, puis une fonction de scoring, puis crée le contact dans le CRM avec le bon score, sans intervention humaine.
- Gestion de tickets support : l’agent lit un email client, détermine la priorité, appelle une fonction de création de ticket dans Jira ou Zendesk avec les bons champs pré-remplis.
- Reporting à la demande : un agent connecté à votre base de données peut générer un rapport sur une période donnée en appelant une fonction SQL, sans que personne n’ait à rédiger la requête manuellement.
La limite réelle n’est pas technique. Elle est organisationnelle. Chaque action que vous voulez déléguer à un agent doit être modélisée comme une fonction documentée, avec ses paramètres, ses cas limites et ses messages d’erreur. C’est un travail de conception, pas juste d’intégration API.
Taux de succès
60-95%
Selon la qualité des tool definitions, pour le même modèle et la même tâche.
Limite pratique
~10 outils
Au-delà, les modèles actuels commencent à confondre les fonctions proches et la fiabilité chute.
Gain opérationnel
3-15h/sem
Sur des tâches répétitives de qualification, ticketing ou reporting, pour des équipes de 5 à 20 personnes.
Nuance
Function calling LLM : la nuance qu’on oublie souvent
Le function calling n’est pas une brique autonome. C’est une brique parmi d’autres dans une architecture d’agent.
Un LLM avec du function calling n’est pas un agent. C’est un LLM capable de générer des appels structurés. Pour avoir un vrai agent, il faut ajouter une boucle de raisonnement, une gestion de la mémoire, et une orchestration des appels successifs.
La confusion entre les deux coûte cher. Des équipes déploient un LLM avec trois fonctions disponibles, appellent ça un «agent autonome», et s’étonnent ensuite que le système échoue dès qu’une étape sort du scénario prévu.
L’autre nuance concerne le Model Context Protocol (MCP). Le MCP est un standard qui permet à des serveurs d’outils de s’exposer à des LLM de façon standardisée, sans que chaque développeur réécrive ses tool definitions depuis zéro. C’est une couche d’abstraction au-dessus du function calling, pas un remplacement. Si vous avez lu notre décryptage du Model Context Protocol, vous savez déjà pourquoi cette distinction est importante pour les équipes qui industrialisent leurs agents.
La vraie maturité sur ce sujet, ce n’est pas de déployer du function calling. C’est de savoir précisément où s’arrête le LLM et où commence votre responsabilité de conception.
Le choix Daremonkey
Le function calling est fiable à 95% quand il est bien conçu, et fragile à 60% quand il ne l’est pas
Le mécanisme du function calling est robuste. Ce qui ne l’est pas, c’est la façon dont la plupart des équipes le déploient : tool definitions vagues, pas de gestion des erreurs, trop d’outils exposés simultanément. Le résultat, c’est un agent qui impressionne en démo et qui échoue en production.
Notre conseil est simple : avant de choisir un modèle ou un framework d’agent, rédigez vos tool definitions comme si vous les écriviez pour un développeur junior qui ne connaît pas votre métier. Si la description est ambiguë pour lui, elle le sera pour le LLM.
Et rappellez-vous la règle d’or : le LLM ne fait qu’écrire. C’est votre code qui agit. Toujours.
À retenir
- Le LLM ne fait qu’écrire : il génère du JSON structuré décrivant une action. L’exécution réelle est toujours assurée par du code applicatif externe.
- La boucle en 6 étapes : requête, décision, génération JSON, exécution code, observation, réponse finale. Le LLM est absent de l’étape 4.
- La fiabilité est dans les tool definitions : une description précise du nom, du rôle et des paramètres de chaque fonction peut faire passer le taux de succès de 60% à 95%.
- Moins d’outils, mieux ciblés : exposer trop de fonctions simultanément dégrade la capacité du modèle à choisir la bonne.
- Function calling ≠ agent autonome : c’est une brique nécessaire, pas suffisante. Une boucle de raisonnement et une gestion de la mémoire sont aussi requises.
Questions fréquentes
Quelle est la différence entre function calling et tool calling ?
Les deux termes décrivent le même mécanisme de base : la capacité d’un LLM à générer un appel structuré vers une fonction externe. «Function calling» est le terme utilisé par OpenAI dans sa documentation. «Tool calling» ou «tool use» est le terme privilégié par Anthropic (Claude) et d’autres fournisseurs. Dans la pratique, ils fonctionnent de façon identique. La distinction terminologique vient des choix de branding des différents éditeurs de modèles, pas d’une différence technique de fond.
Le LLM peut-il vraiment envoyer un email ou modifier mon CRM tout seul ?
Non, jamais tout seul. Le LLM génère un JSON structuré qui décrit l’action à effectuer (par exemple, envoyer un email à telle adresse avec tel contenu). C’est votre code applicatif, ou un framework d’orchestration comme n8n ou LangChain, qui lit ce JSON et exécute réellement l’appel API vers votre outil d’email ou votre CRM. Si votre code ne gère pas correctement les erreurs de l’API, le LLM ne le saura jamais à moins que vous ne lui renvoyiez explicitement le message d’erreur dans le contexte de la conversation.
Comment le Model Context Protocol (MCP) se différencie-t-il du function calling classique ?
Le function calling classique exige que chaque développeur rédige ses propres tool definitions pour chaque modèle et chaque outil. Le MCP (Model Context Protocol) est un standard ouvert qui permet à des serveurs d’outils de s’exposer de façon standardisée à n’importe quel LLM compatible. En pratique, avec MCP, vous n’avez pas à réécrire vos tool definitions pour chaque nouveau modèle : le serveur MCP expose ses capacités dans un format que tous les clients compatibles comprennent. Le function calling reste le mécanisme sous-jacent, MCP est simplement une couche d’abstraction qui le rend plus interopérable.
Pourquoi un agent IA qui fonctionne en démo échoue-t-il en production ?
Plusieurs raisons se cumulent généralement. Les tool definitions sont rédigées pour les cas nominaux mais pas pour les cas limites (paramètre manquant, format inattendu, API indisponible). Le nombre d’outils exposés est trop élevé, ce qui génère des confusions entre fonctions proches. La gestion des erreurs est absente : quand l’API renvoie une erreur 500, l’agent ne sait pas quoi faire et soit boucle, soit répond n’importe quoi. Les démos évitent soigneusement ces scénarios, la production les rencontre systématiquement.
Par où commencer pour déployer du function calling dans mon entreprise ?
Commencez par une seule fonction, sur un cas d’usage répétitif et bien délimité (qualification d’un lead entrant, création d’un ticket support, interrogation d’une base de données interne). Rédigez la tool definition avec un niveau de précision maximal : nom explicite, description du cas d’usage, format exact de chaque paramètre, exemples de valeurs valides. Testez sur 50 cas réels avant d’élargir. Ajoutez une gestion des erreurs explicite qui renvoie au LLM un message clair en cas d’échec. Ne passez à plusieurs fonctions qu’une fois la première stabilisée à plus de 90% de succès.
Vous voulez déployer vos premiers agents IA en production ?
On conçoit l’architecture, les tool definitions et les garde-fous avec vous.